更新于
别再让 AI 只换配色:把界面设计变成可验收的工作流
用一个真实可运行的合成创意验证看板,区分可用性底线、设计取舍与视觉打磨,并用浏览器证据说明验收如何改变交付。
目录
别再让 AI 只换配色:把界面设计变成可验收的工作流
一、页面的问题,常常不在配色
让 AI 把页面做得“更高级”,很容易得到更柔和的背景、更大的圆角,以及另一套标题字体。这些变化可能确实好看,却没有回答一个更重要的问题:用户打开页面后,能否看懂眼前的信息,并完成下一步?
这次我们做一个“AI 创意验证台”。用户手里有几个产品假设,要阅读支持与反对的证据,再决定验证哪个。它不是宣传 AI 能力的落地页,而是一个处理不确定性的工作台。若首屏大半用于展示“每个想法都值得验证”,真正的假设和操作沉到下面,即使视觉很完整,也可能把工作页面的优先级排反了。
但“可能不适合”与“不能使用”是两回事。用户需要滚动才能点击,不自动等于功能失效;按钮没有效果、失败被伪装成空列表,才是明确的可用性问题。反过来,一个页面所有按钮都能点,也不等于信息组织合理。把这两类判断混在一起,评审就容易变成设计师与开发者各说各话。
本文把设计验收理解为一条证据链:先约定用户要完成的动作,再规定不能破坏的条件,然后让页面在真实内容、真实视口和真实状态中接受检查。颜色和字体仍然重要,只是不再承担解释所有问题的责任。
我们会沿着同一条任务走到底:找到“会议纪要转行动项”这个假设,读取一条支持线索和一条反例,发起下一次验证。两版界面都能完成它;差异主要在于页面如何安排注意力。这个前提很重要:不能通过故意造一个坏按钮,来证明另一套设计流程更优秀。
二、先固定需求,再谈两条路径
案例名为“试证”。它包含三条合成假设,涉及会议纪要、商品短视频和课程复习。第一条假设认为,独立顾问需要带原文出处的行动清单。支持线索是“受访者说整理行动项耗时”,反例则是“另一位顾问已有模板,担心遗漏承诺条件”。这些都是教学数据,不代表真实访谈,更不能包装成产品需求已经成立。
两版共享数据、业务脚本和服务端。搜索要实际过滤标题与假设,状态筛选要改变结果,详情要能看到证据,发起验证后要更新列表并在刷新后保留。这里的“发起”仅意味着当前浏览器保存一个进行中状态,不发送邀请、不调用模型、不建立远端任务。界面把这一边界写在操作旁边,而不是藏到文章结尾。
路径 A 的设计输入是常见的视觉请求:柔和紫色、渐变、圆角、醒目的主题介绍、三张等权卡片,让创意看板显得精致且有呼吸感。路径 B 保留相同功能,但加入另一组约束:首屏围绕“下一步验证什么”,证据缺口必须容易找到,手机不能只是把桌面三栏缩小,空数据、错误和键盘操作要有可复现的验收方法。
这不是两次独立模型生成的受控实验。现场可用的 Claude Code 未登录,也没有配置凭据;最终由同一代理在同一上下文中直接编写两个布局和两份样式,并复用业务实现。完整输入保存在案例的 prompts/generation.md。它能展示两种组织方式及其检查过程,不能证明“增加这些提示就必然提升设计”,更不能据此计算成功率。
这个局限并不让案例失去意义。教学对照可以回答:哪些差异能被观察,哪些属于偏好,以及检查究竟发现了什么。它不能回答的是:如果换十个模型、十种产品或十位作者,结果会不会相同。将这两种问题分开,反而能让结论更可信。
三、把验收分成三层,而不是给审美打一个总分
第一层是“必须通过”。它关注承诺是否兑现:数据诚实,控件有效,内容不丢失,键盘能抵达操作,错误有恢复路径。这些条件不能用更漂亮的配色补偿。在试证里,点击“发起验证”后至少要同时发生三件事:详情按钮进入进行中状态、列表状态同步变化、刷新后仍能读回记录。只弹一个“成功”提示不算完成。
第二层是“需要解释”。它处理有代价的设计选择。例如,三张卡片便于同时扫到多个题目,纵向列表则能在同一条目中放下假设、证据缺口和下一步入口。两者没有脱离场景的绝对优劣。评审应该问:当前用户更需要横向浏览题目,还是先读懂一个待处理假设?选择之后,哪些信息被延后,代价是否可接受?
第三层是“最后打磨”。它包括短尾行、局部间距、边线强弱以及色彩节奏。这些细节会影响完成度,却不应与数据丢失排在同一个阻断队列里。本例中,B 版手机副标题的末尾“上。”单独换到下一行,属于值得修整的排版问题;它与“详情打开后看不到标题开头”并不是同一种严重程度。
这样的分层借鉴了 Hallmark 对 Floor、Reflex、Finish 的区分:官方把不可交付的问题、可以说明理由的默认倾向、非阻断的工艺细节分开处理。[1] 但本文没有照搬它的所有风格规则。卡片、渐变、衬线标题都不是天然错误;是否采用,要回到产品任务解释。设计工具中的特定偏好,也不应被改写成普遍的可访问性标准。
分层还有一个工程价值:它改变了修复顺序。发现某个按钮无效,先修行为;发现证据缺口不醒目,讨论信息结构;发现一处文字孤行,留到收尾。团队不必在每一轮都重新争论“什么更重要”。验收不是减少判断,而是把不同性质的判断放回正确的位置。
对这类小项目,一条标准可以写成四段:“条件—动作—预期—证据”。例如:在三百七十五像素宽度和长标题下,打开详情,应该从标题开头开始阅读,并能到达底部关闭按钮;证据是初始滚动位置断言、截图和真实点击记录。这样的要求比“移动端体验良好”多写了几行,却少留下许多解释空间。
四、首屏先决定什么值得看,而不是先决定用什么颜色
A 版把“每个想法,都值得一次验证”放在大面积浅紫色介绍区。它具有完整的视觉主题,也能在桌面列表起点同时露出三个假设标题。问题不是紫色不好看,而是介绍区、搜索和筛选共同消耗了高度,具体行动还没有进入首屏。
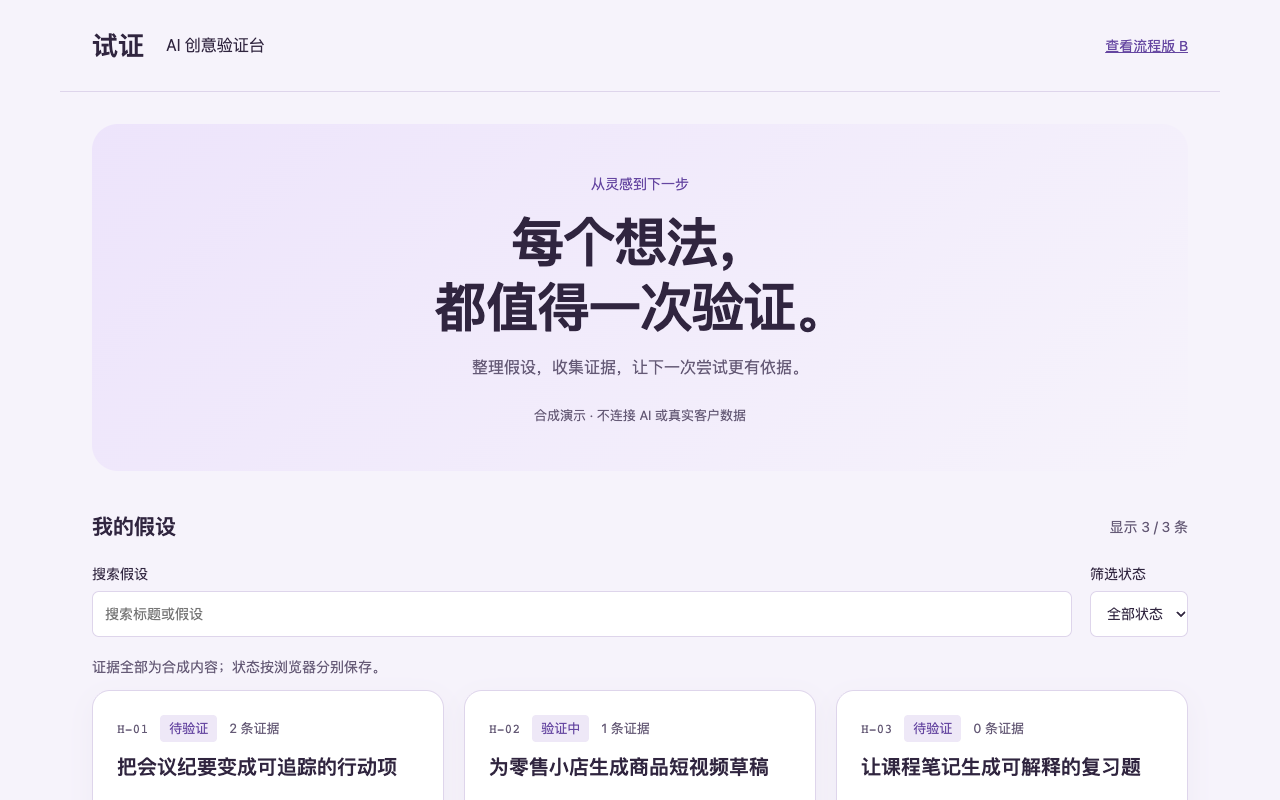
B 版把标题改成“下一步,验证什么?”,压缩介绍区,让假设与证据缺口并列。左边讲“我们相信什么”,右边讲“还不知道什么”,下方保留“查看证据与下一步”。页面的特征不再是一种通用视觉效果,而是把不确定性直接放进阅读路径。
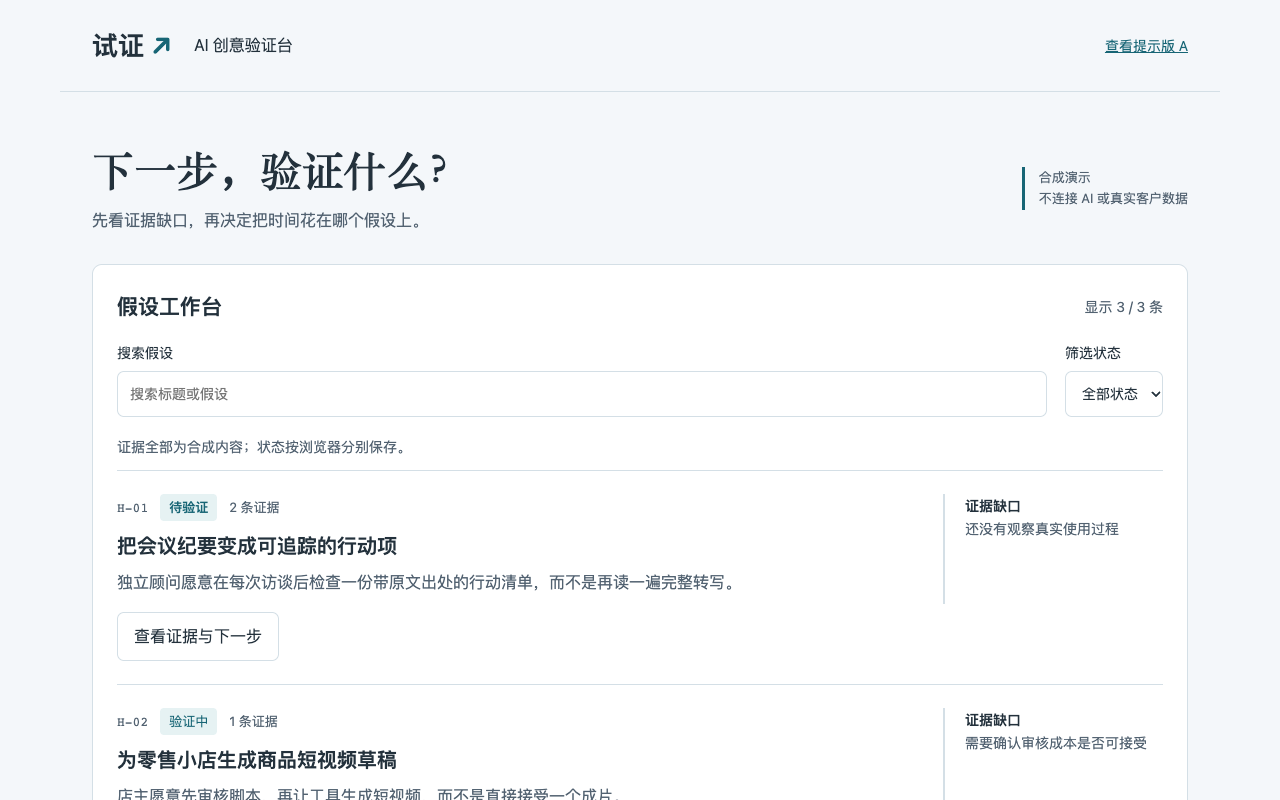
在本机字体和一千二百八十乘八百的视口下,浏览器测得 A 首个详情按钮的顶部约在纵向九百九十三像素,B 约在六百一十二像素。B 的入口进入了首屏,A 的入口需要滚动。这里能够报告的是元素位置,而不是“效率提升多少”:我们没有让真实用户执行任务,也没有计时或记录错误率。
B 同时付出了代价。首屏只能完整呈现第一条,第二条刚开始露出,无法像 A 那样同时看到三个标题。它也没有在列表直接放“发起验证”,而是要求用户进入详情,先看支持与反对线索。这增加一次点击,但保留了这个产品希望培养的工作顺序:不是对标题表态,而是基于证据决定下一步。
在视觉上,B 用浅灰蓝底色承托白色工作区,用青色标识状态和重点,用本机衬线字体区分任务标题,正文继续采用系统无衬线字体。没有加载外部字体,也没有为了“丰富”而添加图表。没有真实置信度,就不画置信度;只有证据数量,就明确标成数量。视觉语言必须服从材料的真实性。
手机上,假设、缺口和操作改为纵向排列。长标题与正文自然撑高,不以截断换取整齐。这个选择保证内容完整,却会增加滚动距离。因此,“没有横向溢出”只是一项底线,不是移动体验的最终结论。若后续增加摘要折叠,还需要重新验证展开、焦点与操作可达性,而不是把折叠当作免费的优化。
五、浏览器要检查状态,而不只检查页面
真正有用的验收不是打开首页截一张图。用户会搜索不存在的内容,会遇到读取失败,也会打开比示例更长的详情。我们给同一个页面增加可复现的场景参数:long 提供长标题与长正文,empty 返回空数组,error 让服务端实际返回 HTTP 503,slow 延迟响应以显示加载状态。
空数据和错误尤其不能混为一谈。空数据意味着成功读到了“没有记录”,页面可以解释当前范围并引导返回示例;错误意味着根本没有取得记录,应说明读取失败并提供重试。若两者都显示“还没有假设”,用户会把系统问题误解为自己的数据消失。这个区别来自状态模型,不是添加一个漂亮插画就能解决。
测试用 Playwright 驱动本机 Chrome。它实际选择状态、输入关键词、点击清除筛选、打开证据、发起验证、刷新页面、关闭详情和重试请求。截图保存在案例 assets/,结构化结果保存在 evidence/browser-results.json。三百二十、七百六十八和一千九百二十像素宽度另做了横向溢出断言,但没有据此宣称所有设备都通过视觉验收。
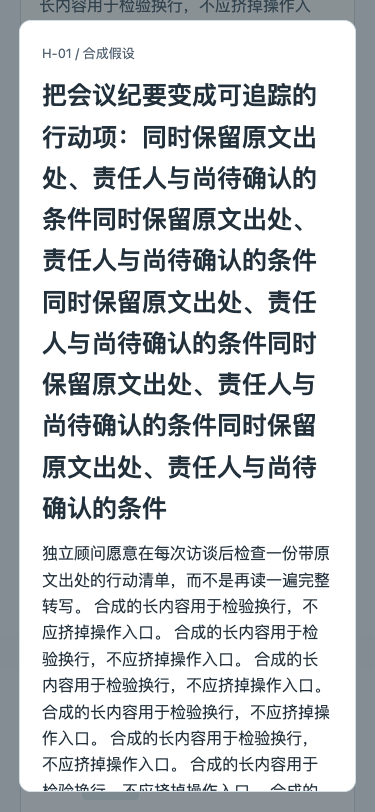
最有价值的发现出现在第一轮测试之后:当时两版的二十个检查组全部通过,长详情的截图却从靠近底部的位置开始,标题开头没有进入视口。原因是原生对话框打开时,把焦点移到了靠后的交互按钮;在长内容里,聚焦动作又把视图滚了下去。自动化检查“对话框存在”,无法发现“用户从错误的位置开始阅读”。
这不是审美意见,而是阅读起点出了问题。修复时,我们让详情标题成为可编程聚焦目标,打开后把焦点交给标题,并将对话框滚动位置归零。两版共享同一个修复,同时增加初始焦点与滚动位置断言。重新跑浏览器后,再读取原尺寸截图,确认长标题从开头显示;随后由脚本真实滚动到关闭按钮并点击。仅仅保存了图片,不足以声称这一步完成。
键盘检查也不止查看 CSS 中有没有 focus-visible。脚本从 Tab 进入跳过链接,再以 Enter 打开详情,检查初始焦点,使用 Escape 关闭并确认返回原入口;另一路用键盘抵达关闭按钮。焦点截图能证明当时的视觉状态,动作断言才能证明焦点实际去了哪里。二者互相补充,不能互相替代。
最终脚本得到两版合计二十二个检查组通过。这里的单位是检查组,不是用户人数、生成次数或全面合规认证。没有测真实读屏、完整对比度、Safari 和真实手机;加载失败也是受控故障注入,不是外部服务事故。把这些边界写清楚,比用一个“全部通过”覆盖所有未知更有用。
六、用同一标准比较,也把代价一起放进结果
同一套功能测试没有分出胜负:两版都能过滤、读证据、更新状态、刷新保留,并从错误中恢复。视觉检查则给出了更具体的区别:A 在桌面起点同时展示更多题目,B 更早展示完整的单项决策上下文;A 的介绍占比更大,B 更像处理任务的工作台。这里没有必要把前者称为“失败设计”。
| 比较项 | A:设计提示版 | B:分层验收版 |
|---|---|---|
| 核心业务操作 | 实际通过 | 实际通过 |
| 桌面首个详情入口 | 首屏下方 | 首屏内 |
| 列表组织 | 等权三卡,可扫多个标题 | 纵向条目,缺口并列 |
| 长内容详情初始问题 | 有,共享修复 | 有,共享修复 |
| 审美优劣、用户效率 | 未测量 | 未测量 |
值得强调的是,B 没有因为写了验收要求就免疫缺陷。它与 A 使用同一个对话框逻辑,也出现同一个自动滚动问题。流程的收益在这里不是“让模型第一次就不犯错”,而是让缺陷变成可观察、可定位、可回归的事项。这也是为什么验收应该跟着产品动作走,而不是跟着某个方案的宣传语走。
成本记录同样需要诚实。此次 A、B 各直接编写一套布局与样式,没有独立编码 CLI 生成,没有多轮整版重抽后只选最好的一张。业务脚本共用,视觉检查后做了一次共同修复批次,再补充检查并复跑。用户没有逐行改码;布局、数据、测试和修复都由同一代理完成,作者偏差仍然存在。
我们保留了环境版本、命令、初轮结果、修复前截图和最终结果,却没有可靠的模型费用账单,也没有分别计量两条路径的纯生成耗时。因此不能说 B 更省钱,更不能把整个会话的工具等待时间当作设计效率。可以确认的额外工作是:写出标准、准备异常数据、运行浏览器、读截图、修复并回归。它们花费时间,却使“完成”有了可以核对的含义。
独立评审仍是未完成的一环。当前读图属于作者借助视觉工具自查,不是陌生上下文里的第二位评审者。案例已留下本地地址、截图、原始结果与待复核问题,供另一位评审者先观察再读作者结论。不能因为自动检查通过,就把这个空缺自动填成“独立审查通过”。
七、可复用的是验收契约,Hallmark 是实现这种纪律的一种方式
下一次让 AI 构建界面时,可以把请求从“做得高级一点”改成下面这份短契约。它不规定每个页面长得一样,而是规定设计必须回答什么。
对象:谁在什么情境使用?
任务:进入页面后,要完成哪一个主要动作?
材料:哪些内容真实,哪些合成,哪些尚不存在?
必须通过:行为、状态、内容完整性、键盘与窄屏底线。
需要解释:首屏顺序、主要入口、密度,以及被牺牲的信息。
最后打磨:排版、间距、边线与视觉一致性。
证据:同视口截图、真实操作记录、失败与长内容场景。
复核:谁独立评审?哪些没有测试?修复后怎样回归?
附带案例保留了这份契约、两版源代码、完整提示、检查脚本和验收报告。解压案例包后,从解压根目录启动:
cd examples/ui-design-acceptance
node server.mjs
浏览器打开 http://127.0.0.1:4173/b.html,或把路径改为 a.html 查看另一版。服务保持运行,在同目录的另一个终端执行 npm ci --ignore-scripts 和 npm test。页面本身只需 Node;自动检查还需要本机 Chrome,首次安装测试依赖需要网络。使用轻量实现,是为了让读者直接检查从按钮、状态到存储的完整路径,而不是把“框架成功编译”误认为业务已经完成。环境版本、重置方式和替代浏览器路径都写在案例 README 中。
Hallmark 值得参考的地方,是它把这类要求组织成可执行的工作流。固定版本的 README 描述了读取项目约束、围绕任务构建页面、先做首屏、真实浏览器检查和新上下文评审;SKILL 文档进一步规定先构建首屏、检查并评审,再继续页面。[1][2] 这比一段颜色和字体建议覆盖的范围大得多,但文档规定流程,不等于每次宿主运行都已完成流程。
我们还核对了具体实现。sloplint.mjs 解析参数与文件,在渲染选项开启时动态加载 sloplint-render.mjs,把本地 HTML 或页面地址交给渲染检查;无法执行时保留未运行信息,而不是把不存在的结果当成通过。[3] 渲染模块查找 Puppeteer 和 Chrome,启动浏览器,切换视口、截图、收集运行错误,并执行包括键盘焦点在内的检查。[4] 因此它不是单靠提示词“想象”页面会怎样,也不是无论宿主环境如何都自动具备浏览器能力。
源码固定在提交 6033bab2a8051b5454552d2e8e6cb8f27c483a42。本文只做官方描述与源码路径核验,没有安装或调用 Hallmark,也没有运行它的 lint 或评审。案例的服务端、界面与 Playwright 脚本都是自建实现,只借鉴分层验收思路。把“读过工具”“借鉴方法”和“实际运行工具”分开,是技术文章必须保留的边界。
可复用的最终成果,不是一套人人都该采用的紫色或青色主题,而是一份带证据的交付契约:功能是否兑现、为什么这样排列、哪些细节尚待打磨、由谁复核。AI 仍然负责提出设计,人仍然可以有审美偏好;只是当页面需要交付时,不能再用“看起来不错”替代“我知道它为什么这样设计,也知道它实际怎样工作”。